
Опубликовано: 13.08.2023
Обновлено: 17.09.2025
LSI (Latent Semantic Indexing) – это метод анализа и индексирования текста, используемый для определения семантической связи между словами и понятиями в текстовых документах. Алгоритм LSI позволяет определить тематическую связь между словами, даже если они не синонимы или явно не связаны друг с другом.
Содержание
показать
Особенности модели
Представьте LSI (Латентно-семантическое индексирование) как очень умного библиотекаря для поисковых систем. Если обычный поиск ищет точное совпадение слов, то LSI понимает, что тексты про «машины», «двигатели» и «шины» тоже относятся к теме автомобилей, даже если в них нет самого слова «автомобиль». Этот метод анализирует большие объемы текстов и выявляет «скрытые» (латентные) смысловые (семантические) связи между словами и целыми документами. Проще говоря, LSI помогает поиску понять не просто какие слова вы ввели, а что вы имели в виду, и находить более релевантные результаты по общему смыслу, а не по буквальному совпадению.
При использовании метода LSI текстовые документы представляются в виде математических моделей, известных как матрицы терминов-понятий. В этих матрицах каждый столбец представляет термин, а каждая строка представляет документ. Затем проводится снижение размерности матрицы с помощью сингулярного разложения (Singular Value Decomposition – SVD), это позволяет найти скрытые связи между терминами и документами.
Модель LSI сама по себе никогда не использовалась в поисковых алгоритмах: этот метод анализа был разработан до эпохи интернета, и использовался для концептуального поиска документов в библиотечных коллекциях. В практике SEO термином LSI совершенно ошибочно называют любые методы с дистрибутивной семантикой и выявлением близости слов: любой контент, соответствующий интенту пользователя, а не заданным для поиска ключевым словам.
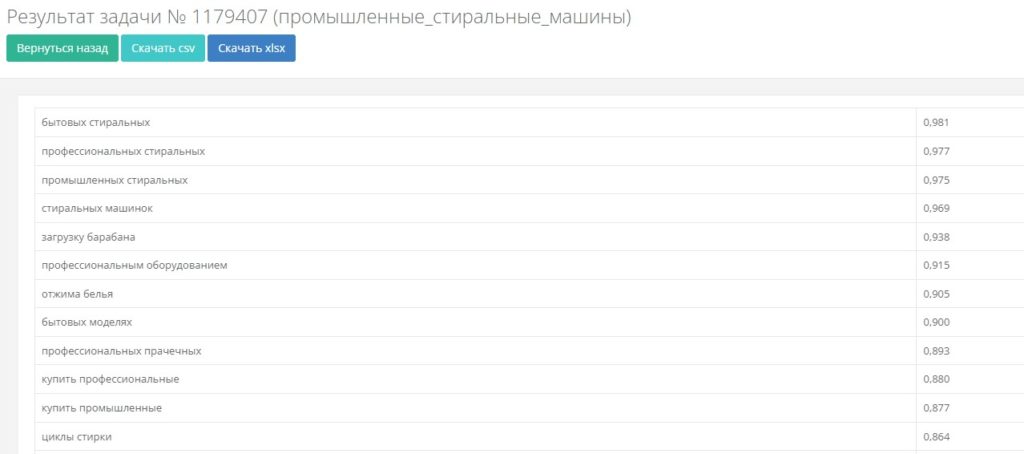
Пример выгрузки тематически связанных слов по запросу “промышленные стиральные машины” из сервиса “Акварель-Генератор”. В правой колонке – коэффициент соответствия основному запросу.
Основные принципы LSI
- Текст представляется в виде «мешка слов». Порядок слов и их близость друг к другу значения не имеют.
- Документ относится к той или иной тематике/группе на основании терминов (слов), которые в нем содержатся и частоты этих терминов (количества раз, которые они встречаются в документе).
- Каждое слово имеет единственное значение. Это не совсем корректное допущение, но оно необходимо для построения модели.
От матриц к нейросетям: эволюция семантического анализа
Латентно-семантический анализ (LSI) является одним из ранних методов векторного представления слов. Его основной принцип — разложение матрицы «термин-документ» с помощью сингулярного разложения (SVD). Этот процесс позволяет выявить скрытые (латентные) семантические связи, сжимая исходное пространство признаков в пространство меньшей размерности. Таким образом, LSI учится на глобальных со-встречаемостях слов в рамках целых документов, представляя слова в виде векторов, где близость векторов указывает на семантическую схожесть.
Word2vec представляет собой более современный и эффективный подход, основанный на нейронных сетях. В отличие от LSI, который анализирует глобальную статистику по всему корпусу, word2vec обучается на локальных контекстах. Модель предсказывает целевое слово на основе окружающих его слов (контекста) или наоборот. Этот метод позволяет получать плотные, малоразмерные векторные представления (эмбеддинги), которые лучше улавливают тонкие семантические и синтаксические взаимосвязи между словами.
Связь между LSI и word2vec можно рассматривать как эволюционную: оба метода стремятся представить семантику слов в виде векторов в многомерном пространстве. Однако если LSI является «считающим» методом, основанным на факторизации матриц, то word2vec — это «предсказательный» метод, использующий нейросети. Переход от анализа глобальных со-встречаемостей в документах (LSI) к предсказанию на основе узкого контекстного окна (word2vec) позволил добиться значительно более качественных и гибких векторных моделей, которые стали стандартом в современном NLP.
Сфера применения
- LSI помогает в определении связи между словами, идентификации семантических аспектов документа и анализе его смысла.
- Релевантные результаты поиска. LSI применяется в поисковых системах для улучшения результатов поиска. Он позволяет вывести более релевантные документы, даже если они не содержат точно совпадающие ключевые слова.
- Кластеризация документов. LSI позволяет группировать схожие документы в кластеры на основе их семантической связи. Это помогает организовать большие объемы информации и облегчает навигацию по текстовым корпусам.
Латентно-семантическое индексирование (или латентно-семантический анализ) применялось к многочисленным задачам из области компьютерных наук – от моделирования памяти до компьютерного зрения.
Хофман (Нofmann, 1999) предложил первоначальное вероятностное расширение основных методов латентно-семантического индексирования (pLSI – probabilistic LSI).
Более формальной основой вероятностной модели латентной переменной для снижения размерности является латентное размещение Дирихле (Latent Dirichlet Allocation – LDA). Эта порождающая модель приписывает вероятности документам, не принадлежащим обучающему множеству. Она была расширена для иерархической кластеризации. Вай и Крофт (Wei and Croft, 2006) провели первое крупномасштабное исследование модели LDA и продемонстрировали, что она значительно превосходит (языковую) модель правдоподобия запроса), но уступает модели релевантности, хотя в модели релевантности, в отличие от модели LDA, предусмотрена предварительная обработка запроса. Те и др. (Teh et al., 2006) обобщили этот подход, предложив иерархические процессы Дирихле (Hierarchical Dirichlet рrосеssеs) вероятностную модель, позволяющую извлекать группу (в нашем случае – документ) из бесконечной смеси латентных тем, при этом одной теме может соответствовать много документов.
LSI и QBST
Латентно-семантическое индексирование (LSI) представляет собой метод анализа, позволяющий поисковым системам понимать не только прямые ключевые слова, но и скрытые связи между терминами и концепциями в большом объеме текста. Эта технология помогает определить, что документы о «автомобилях» и «машинах» семантически близки, даже если в них используются разные слова для описания одного и того же. По сути, LSI строит многомерное семантическое пространство, где слова и целые документы, близкие по значению, располагаются рядом друг с другом, формируя основу для более глубокого понимания контента.
На базе этого глубокого семантического понимания и возникает концепция запросно-ориентированных значимых терминов (QBST). Когда пользователь вводит запрос, система, используя принципы, схожие с LSI, анализирует семантическое окружение этого запроса. Она определяет наиболее важные, статистически и контекстуально связанные с ним слова и фразы — те самые QBST. Эти термины, часто встречающиеся вместе в авторитетных документах по теме, служат маркерами, которые помогают поисковой системе уточнить намерение пользователя и значительно повысить релевантность результатов поиска. LSI создает семантическую карту, а QBST являются ключевыми ориентирами на этой карте, которые активируются конкретным поисковым запросом для нахождения наиболее точного маршрута к информации.
